こんにちは、デジナーレ福岡オフィスの大坪です。
今回は「レスポンシブサイトの画面設計」についての考え方や重要なポイントを共有したいと思います。レスポンシブデザインは、異なるデバイスで一貫したユーザーエクスペリエンスを提供するために不可欠です。このブログでは、効果的なレスポンシブサイトを設計するための基本的なステップと考慮すべき点に焦点を当てて考えてみたいと思います。
コンテンツファーストでの制作ステップ
コンテンツファーストとは?
文字通りコンテンツ(内容)を先に洗いだして細かい要件などを書き出し、ワイヤーフレームやデザインの作成はその後に行います。こうすることで無理なくレスポンシブのメリットを生かせたウェブサイトを構築することが可能になります。
従来の設計と何が違うのか?
従来はデザインファーストのように、視覚的な魅力を優先してデザインされ、その枠組みにコンテンツを当てはめていく手法が主流でした。しかし、美しいデザインがある一方で、使いやすさや欲しい情報がすぐに得られるかといったことが犠牲になってしまいます。
デザインの面でも、画面構成で無理が生じると最悪の場合、振出しに戻り、情報設計から行わなければならなくなります。
その一方で、コンテンツファーストではユーザー体験を最適化し、情報がアクセスしやすく、かつ機能的なウェブサイトが実現可能です。
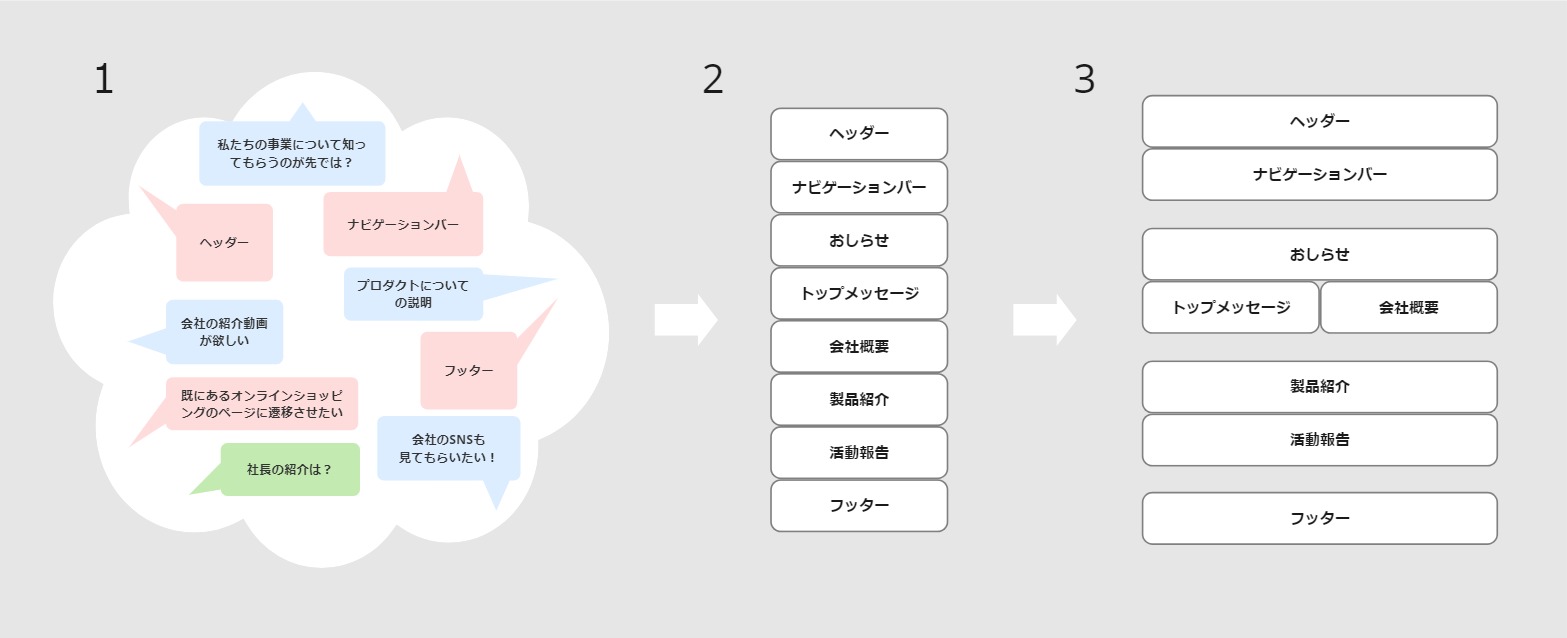
ウェブサイトを構築するために抑えておきたい3つの手順
1. コンポーネントの洗い出し
ターゲットとそのニーズを理解した上で、画面に必要なすべてのコンテンツの内容、そのコンテンツの優先順位付けといった洗い出しを行います。
2.コンポーネントの順序設定
コンテンツの洗い出しが出来たら、そのコンテンツをどのように配置していくか、ページの構造を設計します。情報の重要度や優先順位を元に、コンポーネントを縦一列に配置します。
3.コンポーネントのグルーピング
配置されたコンポーネントはバラバラになっているので、関連するコンポーネントをグループ化し、最終的なレイアウトに反映します。その後、ワイヤーフレームやより細かいビジュアルデザインを詰めていきます。
-
-
コンテンツファーストでの制作フロー
ワイヤーフレームの利用
ユーザーの目的に応じた操作性と視覚的な魅力を考慮しながら、サイト全体の設計図(ワイヤーフレーム)を基にデザインを進めます。このワイヤーフレームを元に、ビジュアルデザインを行い、使い勝手とブランドイメージを向上させた後、実装作業へと移行します。
このワイヤーフレームはエンジニアに対するコーディングの指示書の役割も果たしているので、ページ遷移や機能の要件、ページの階層なども明確にしておく必要があります。
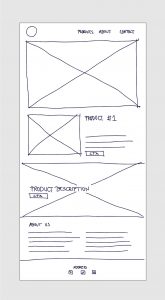
miroなどのサービスを使えば、簡単にテンプレートからワイヤーフレームの作成を始めることも可能です。
レスポンシブデザインの基本
レスポンシブサイトでは、異なるデバイスで同じHTML構造を使用することが原則です。最初の設計段階で適切な計画がなされていない場合、情報設計工程まで戻って修正が必要になることがあります。これを避けるためには、初期段階での正確な計画が不可欠です。
ブレイクポイントの設定
デザインのレイアウトを崩れることなく適切に展開していくためには、一定の画面幅を基準にして、CSSを使用してレイアウトを切り替えていきます。画面の幅が変更されたときにレイアウトが切り替わるポイントのことをブレイクポイントといい、レスポンシブのあるウェブサイトではこのブレイクポイントが必要不可欠です。ブレイクポイントを大きく分類すると二つあり、
- メジャーブレイクポイント: スマホとPCなど、画面レイアウトを劇的に変更されるブレイクポイント
- マイナーブレイクポイント: 部分的なレイアウト調整用に設定されるブレイクポイント
があります。どこにブレイクポイントを設けるのかは実際のプロジェクトによってルールが異なったり、配置しているコンテンツ、ウェブサイトのメインユーザー層、どのデバイスでの使用を目的にしているのかによっても変わります。ですが基本として、これらのブレイクポイントを組み合わせて実装していくことになるでしょう。
まとめ
レスポンシブサイトの設計は、計画的かつ段階的なアプローチが求められます。コンポーネントの洗い出しからブレイクポイントの設定まで、各ステップはサイトの使用感と機能性に直接影響します。今回共有した設計手順が、皆様の実務現場で役に立つことができれば幸いです。
こんにちは、デジナーレ福岡オフィスの徳安です。
この記事では、「Zod」について紹介します。
「Zod」とは
Zodとは、TypeScript向けの
1つの定義から、TypeScriptの型定義と
スキーマバリデーションの定義を生成できる為、
Typescriptとの相性が非常に良い。
依存パッケージが無いことや
バンドルサイズが小さいといった特徴もある。
Zodを使用すると、
型安全な方法でデータ構造を定義し、
それに基づいてデータを検証できる。
基本的な使い方
インストール方法
|
|
npm install zod # npm yarn add zod # yarn bun add zod # bun pnpm add zod # pnpm |
スキーマメソッド
*.parse
.parse(data: unknown): T
任意の Zod スキーマを指定、
.parseメソッドを呼び出し、
(.parse(data))引数に、対象の値を入れることで、
対象の値が有効であるかを検証することができる。
エラーの場合は、ZodErrorがスローされる。
<例>
|
|
import { z } from"zod"; // 文字列のスキーマの作成 constmySchema = z.string(); // parsing ============== mySchema.parse("string"); // => "string" mySchema.parse(12); // => throws ZodError |
*.safeParse
.safeParse(data:unknown): { success: true; data: T; }
| { success: false; error: ZodError; }
検証が失敗したときに ZodErrorをスローしたくない場合は、
.safeParseを使用する。
正常に解析されたデータを含むオブジェクト、
または検証の問題に関する詳細情報を含む
ZodError インスタンスを返す。
<例>
|
|
import { z } from"zod"; // 文字列のスキーマの作成 constmySchema = z.string(); // parsing ============== stringSchema.safeParse(12); // => { success: false; error: ZodError } stringSchema.safeParse("billie"); // => { success: true; data: 'billie' } |
stringのschemaに用意されたメソッド
<例>
|
|
z.string(); // 単純な文字列 z.string().min(5); // 5文字以上の文字列 z.string().max(5); // 5文字以下の文字列 z.string().length(5); // 固定幅の文字列 z.string().email(); // メールアドレス文字列 z.string().url(); // URL文字列 z.string().uuid(); // UUID文字列 z.string().regex(regex); // 正規表現にマッチする文字列 z.string().nonempty(); // 空文字列以外の文字列 |
ネストしたり値をオプショナルにしたりと、
自由度が高く定義することもできる。
エラーメッセージのカスタマイズ
エラーメッセージをカスタマイズすることもできる。
<例>
|
|
import { z } from"zod"; constname = z.string({ required_error:"Name is required", invalid_type_error:"Name must be a string", }); |
オブジェクト
z.objectを使用して、
オブジェクトスキーマを定義できる
また、z.infer<typeofSchema>を使用して、
任意のスキーマから 型を生成できる
<例>
|
|
import { z } from"zod"; constDog = z.object({ name:z.string(), age:z.number(), }); // スキーマから型を抽出 typeDog = z.infer<typeofDog>; |
ここまで読み進めていただきありがとうございます。
こんにちは、デジナーレの原田です。
2024年2月26日(月)から2024年2月29日(木)の4日間、スペインのバルセロナで開催された世界最大級のモバイル業界見本市「MWC Barcelona 2024」に参加してきました。
今回、弊社のお客様のプロモーション施策の一つとして、
業界最大の展示会に出展し、ブース展示のみならず、重要な商談やステージ講演、
メディア取材などさまざまな活動を行いました。
この展示会は、これまでお客様と共に実施してきた数々のプロモーション施策の中でも、
集大成と言える大きなプロジェクトでした。
その中で、私はMWC出展におけるプロジェクトマネジメントや展示ディレクションなどを担当し、
現地バルセロナにも同行しました。
本日は、その様子を少し紹介します!
開催初日、まだ肌寒い夜明け前。出展準備のため、私たちは会場に向かいました。
正面に飾られた、“MWC” の迫力あるオブジェが目を惹きます。

緊張感もありましたが、2023年の7月頃から地道にMWCの準備を進めてきたので、
「無事にこの日を迎えられた!」と少しホッとしたことを覚えています。
こちらはエントランスの様子。
今回のMWC24全体の来場者は約10.1万人。過去最高のMWC19の10.7万人に迫る賑わいとなりました。

今回のテーマは「Future First」。
AIを絡めたソリューションや5Gの収益化などが注目を集めていました。
会場には、世界各国の名だたる企業がバルセロナに集結しています!
ものすごい迫力(°°)…!!


私自身、国内外ともに展示会は何度か担当し、国内展示会への同行経験はあるのですが、
海外展示会への同行は初めての経験でした。
担当した展示やステージ講演に関しては、残念ながらこちらに掲載することはできないのですが、、、
展示会は、無事大成功を収めることができました!!!
今回、本件に携わらせていただいた中で、特に印象的だったことをまとめてみました。
▼準備フェーズ
●今回、展示物の制作だけでなく、展示ブースや商談ルームのデザインにもメインで携わりました。「なぜこのようなデザインにするのか」というコンセプト設計からそれを実現していく過程や、各コンテンツがそのコンセプトと合致しているかを確認しながら検討することが、今までにない体験でとても印象に残っています。クリエイティブメンバーと何度も議論し、試行錯誤を重ね、チームの想いが伝わるデザインに仕上がりました。
●展示会では、その企業の社員がブース内で来場者にサービス案内を行うことがよくあります(以下説明員とする)。今回は大規模な展示会のため、説明員の人数が多く、かつ初めて説明員を経験するメンバーがほとんどでした。そこでサービス案内のクオリティを保つために、渡航前に「レクチャー会」と「ロープレ会」を実施しました。説明員経験者の方をお呼びしてレクチャーをしたり、海外メンバーをお呼びして英語の指導を交えながら行ったり、より本番に近い状況で練習を重ね、本番に備えられるようにサポートしました。
▼現地対応
●ロジ周りの準備や設計に大変苦労しました。展示、商談、講演、取材など施策が盛りだくさんだったため、それぞれにおける準備と、それを現地でスムーズに進行するためのロジ設計には多大な時間を要しました。また、海外展示会なだけあって、資料は英語と日本語の2種類を作成する必要があったり、英語でメール対応をする必要があったりと、海外の方とのやりとりも多々発生しました。
●どれだけ事前に想定で準備をしていても、実際に現地に行ってみなければわからないことがとても多いです。来場者の入り具合や巡回の導線、講演するステージや客席の位置、撮影カメラの位置など、事前に把握するのが難しいことも多く、現場で毎日打ち合わせを行い臨機応変に対応しました。
●展示ブースや商談ルームの施工において、国内と海外での施工技術の違いが大きかったです。日本では当たり前と思われるようなものが想定外の仕様になっているということがあり、驚きもありましたが、次回以降のデザインや施工指示をする際の参考になりました。
本当にたくさんの方々が関わり合い、力を一つにして作り上げた展示会だったと実感しています。
メンバーの一員として携われたこと、大変嬉しく思います。
そしてMWCを通して、
多くのことを学び貴重な経験させていただいたことに心から感謝しています。
本当にありがとうございました!!
東京オフィスデザイナーの井手です。
今回このブログでは、Googleタグマネージャーとは何なのか、GA4のタグとの違い、Googleタグマネージャーの使い方について紹介します。
Googleタグマネージャーとは
Googleタグマネージャーは、Googleが無料で提供しているタグ管理システムです。
ウェブサイトやアプリに設定しているタグを簡単に管理することができます。
Googleタグマネージャーで出来ること
GA4タグとの違い
Webサイトやアプリの分析をするとにき、GA4でもイベント(タグ)の作成ができますが、Googleタグマネージャーではより細かい設定が可能です。スクロールを計測するイベントの設定を例にご紹介します。
GA4の場合
GA4のスクロールを把握するイベント「scroll」では、スクロールの距離が、ページの90%に到達した時に集計が行われます。90%以外の数値を設定することはできません。
Googleタグマネージャーの場合
Googleタグマネージャーでは、スクロールの距離を細かく設定することが可能です。5%~100%まで設定することで細かいスクロール値を取得することができ、より詳細な情報を得ることができます。

Googleタグマネージャーの使い方
①組み込み変数の設定を行います。
変数を設定することで、ある値や情報を後で入力するための仮の場所を確保します。
■変数の設定
②トリガーの設定を行います。
トリガーは、タグを配信するときの条件のことです。
トリガーのタイプを選択し、トリガーの詳細設定・トリガーの発生場所の指定をすることができます。
■トリガーのタイプを選択
■トリガーの詳細設定
スクロールの距離は、ページの高さまたは幅に対する割合(%)、またはピクセル数で設定します。割合を選択して、「10, 20, 30」と入力すると、ページの高さの 10%、20%、30% の地点がそれぞれトリガーの発動ポイントに設定されます。
また、特定のページのみスクロールを計測したい場合には、このトリガーの発生場所の一部のページを選択後、特定のページのURLを設定することで計測ができ、全てのページで取得したい場合には、このトリガーの発生場所のすべてのページを設定することで計測することができます。
補足
トリガーが発動するのは各ページで発動ポイントを初めて通過した時のみで、ページ上部にスクロールして戻ってもトリガーは発動しません。ページの再読み込みした場合には、再度トリガーが発動可能になります。
③タグの設定を行います。
タグでは、埋め込む場所の設定と、トリガーの選択を行います。
■タグタイプを選択
(今回はGA4と連携する為、GoogleアナリティクスのGA4を選択)
■GA4のID・イベント名・イベントパラメータを設定する。
■トリガーの選択
④プレビューで動作確認を行います。
プレビューで動作のテストを行うことで、設定したタグが正常動いているか確認することができます。
■タグを選択し、右上のプレビューボタンを押します。
■プレビューから飛んだサイトで実際に動作を試します。
■Summaryに動作の結果が表示されます。
- Tags Fired→正常に動作している
- Tags Not Fired→正常に動作していない
正常に動作していることを確認してからGA4で設定を行うようにしましょう!
■GA4側で確認
正しく設定できた場合には、GA4のレポート>リアルタイム>イベントで確認ができます。
最後に
今回はGoogleタグマネージャーについて紹介しました。
Googleタグマネージャーが使えるようになると、分析の時に知りたい情報をより得ることができるようになり、タグも簡単に管理することができるようになります。
Googleタグマネージャーで目的に合ったタグの設定を試してみましょう!
新年、明けましておめでとうございます。
旧年中は格別のお引き立てを賜り、厚く御礼申し上げます。
今後も変わらぬご指導と、末永いお付き合いをお願い申し上げます。

皆様のご多幸と繁栄をお祈り申し上げます。
令和6年 元旦
株式会社デジナーレ
日頃はご愛顧を賜り厚く御礼申し上げます。
誠に勝手ながら休業期間を下記の通りとさせて頂きます。
ご迷惑をお掛け致しますが、何卒ご了承願います。
<休業期間>
2023年12月29日(金)~2024年1月3日(水)
※2024年1月4日(木)から通常営業致します。
※休業期間中、Webサイトからのお問い合わせは通常通り受け付けておりますが、ご連絡は2024年1月3日(水)以降となります。
こんにちは、デジナーレ福岡オフィスの徳安です。
この記事では、useCallbackについて説明します。
useCallbackとは
|
|
const cashedFn = useCallback(fn, dependencies) |
構文
|
|
useCallback(fn, dependencies) |
コンポーネントのトップレベルでuseCallbackを呼び出し、
再レンダー間で関数定義をキャッシュする。
引数
fn: キャッシュしたい関数の値を設定する
dependencies: 依存配列を設定する。
依存配列を[](空)で設定すると、Reactは再び同じ関数を返却する。
<注意>
■useCallbackはフックなのでコンポーネントのトップレベル、
または独自のフックでのみ呼び出すことができる。
ループや条件式の中で呼び出すことはできない。
■React は、特定の理由がない限り、
キャッシュされた関数を破棄しない。
useMemoとuseCallbackについての違い
useMemoとuseCallbackの違いはキャッシュできる内容
useMemoは関数の呼び出し結果をキャッシュする。
対するuseCallbackは関数自体をキャッシュする。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 |
export const Counter = () => { const [countStateA, setCountStateA] = useState(0); const [countStateB, setCountStateB] = useState(0); //useCallbackは関数をメモ化するフック useMemoは関数の結果をメモ化するフック memo はコンポーネントの結果をメモ化するフック const countIncrementA = useCallback(() => setCountStateA(countStateA + 1), [countStateA]); const countIncrementB = useCallback(() => setCountStateB(countStateB + 1), [countStateB]); return ( <> useCallbackのコード <p>Aボタン{countStateA}</p> <p>Bボタン{countStateB}</p> <CountResult text="Aボタン" countState={countIncrementA}> Aボタン </CountResult> <CountResult text="Bボタン" countState={countIncrementB}> Bボタン </CountResult> </> ); } |
|
|
import { memo } from "react"; export const CountResult = memo(({ text, countState }) => { console.log(`${text}がクリックされました。`); return ( <> <button onClick={countState}>{text}</button> </> ); }); |
初回レンダリング時

*Aボタン押下時 *Bボタン押下時


このようにuseMemoとuseCallbackを併用してメモ化することで、
不要なレンダリングが行われないようになり、
パフォーマンスの最適化が可能となる。
まとめ
useCallbackとは...?
*関数をメモ化することができる
*メモ化することで不要なレンダリングを防ぐことができる
*パフォーマンスを向上させることができる
useCallbackの使い方のまとめ
第一引数にはコールバック関数を記述する
第二引数には依存配列を記載する
依存配列は[]でもOK
ただし関数が定義されるのは初回実行時のみ
依存配列に値を格納することができる
格納された値が更新される度に関数が再定義される
ここまで読み進めていただきありがとうございます。
こんにちは、デジナーレ福岡オフィスの徳安です。
今回は、AWSのオンラインイベント「AWSomeDay」に参加したので、
講習のまとめと健忘録を兼ねてブログを書きます。
モジュール1: AWS の概要、グローバルインフラストラクチャとコンピューティング
AWSとは?
アマゾン ウェブ サービス (AWS) は、
世界で最も幅広く採用されている、
包括的なクラウドプラットフォーム。
クラウドコンピューティングサービスが登場する前までは、
サーバーを利用する必要があれば、自社の建物の中などにサーバー機器を設置して
利用するのが一般的だった。
オンプレミスでは、サーバー機器を購入し
管理しなければならないのはもちろんのこと、
設置するスペースも確保する必要がある。
サーバー機器を購入するのための初期費用が掛かり
納期が長ければ使えるまで時間がかかることもあった。
対するクラウドコンピューティングでは、
「サーバー機器を購入する」、「管理する」
「スペースを確保する」、「納期の間、待つ」といった必要がない。
クラウドコンピューティングの登場によって、
スピーディーかつ手軽に利用できるようになった。
クラウドサービスの分類
AWSのクラウドサービスは、
アンマネージドサービスとマネージドサービスの
2種類に分類することができる。
*アンマネージドサービス
オンプレの環境を
そのままクラウドに持ってきやすいという点と
OSやスペックに対して、細かな調整ができる点がメリット!!
*マネージドサービス
サーバーレスとは??
サーバーがないという意味でなく、開発者はプログラムを入れるだけで、
サーバーを意識することなく
AWSが実行、停止をすべて自動で行ってくれることから、
サーバーレスと言われている。
モジュール2: ストレージとデータベース
クラウドストレージサービスとは?
ストレージサービスとは、
インターネット上にあるストレージ(ファイル保管用のスペース)に
データを保存できるサービスのこと。
AWSのストレージには、
ファイルストレージ・ブロックストレージ・オブジェクトストレージが存在する。
AWS にはさまざまなストレージオプションが用意されているが、
データの種類に応じて、適切なストレージを選択することが重要
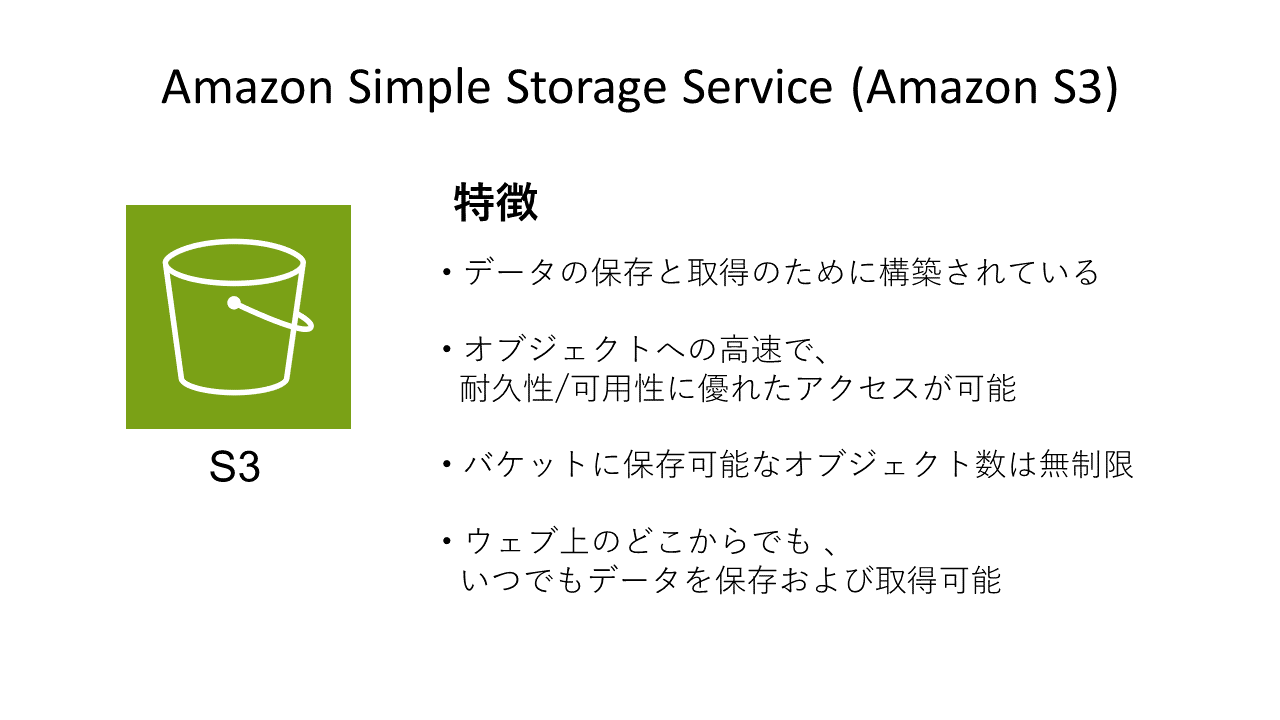
共有ストレージ S3
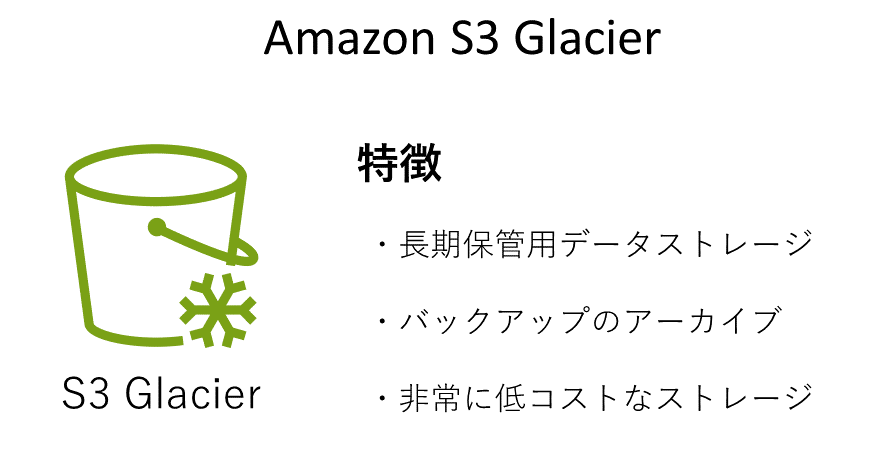
長期の保管
データベースについて
*リレーショナルデータベース(RDBMS)
リレーショナルデータベースとは事前に定義された、
データ項目の集合体で関連があるデータを表形式で扱うデータベース。
*NoSQL
リレーショナルデータベースではないデータベースの総称をNoSQLと呼ぶ。
リレーショナルデータベースに比べて、
処理速度が高速で、格納できるデータの種類が豊富など利点がある。
*トランザクションデータベース
複数人がアクセスするページや、
状況によって表示を切り替えるなど、
細かいデータの管理に向いている。
例:ユーザー情報、商品情報、在庫情報
*データ分析/リレーションシップ
複数のデータを読み込んで分析することに向いている。
*インメモリデータストアとキャッシュ
一時的なデータの保管などで、
スピーディーに読み書きしたい場合に向く。
例:セッション情報、ショッピングカート
AWS には、さまざまなデータベースオプションが用意されているので、
用途に合わせて選択する必要がある。
モジュール3: ネットワークとセキュリティ
ネットワーク
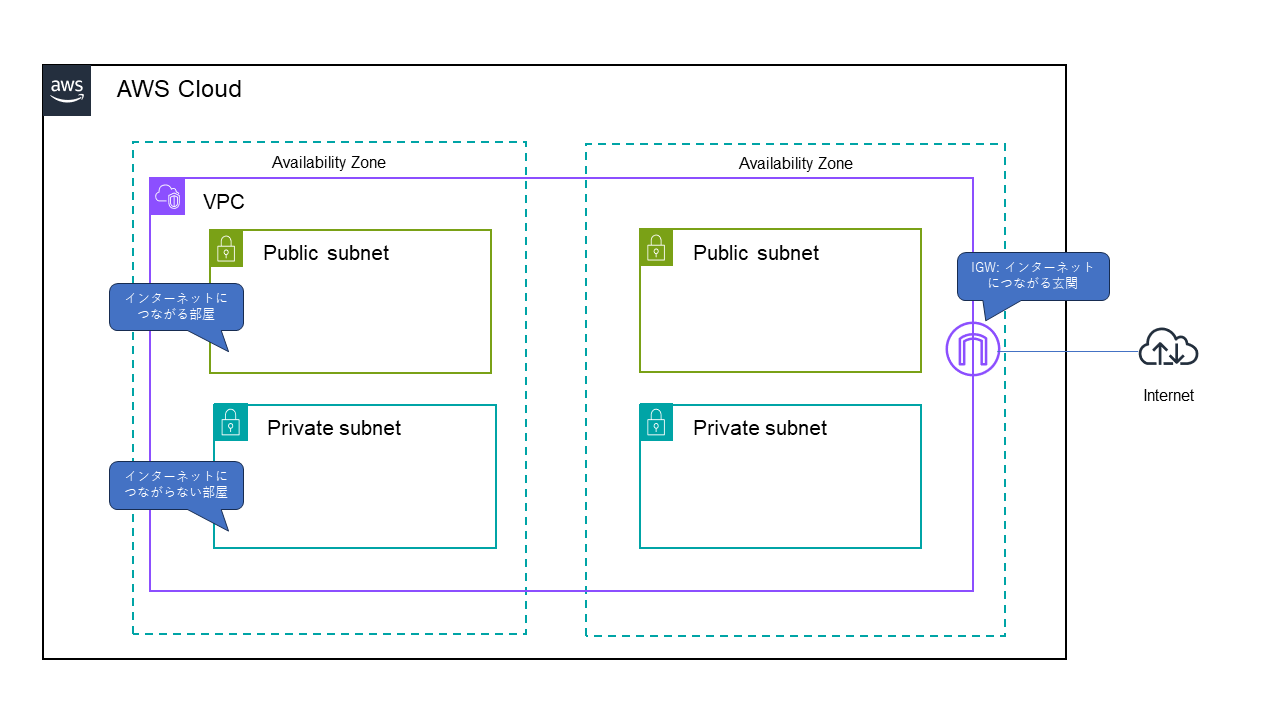
Amazon Virtual Private Cloud(Amazon VPC)は、
AWS上にプライベートな仮想ネットワーク環境を構築することができるサービス。
<具体例>
「セキュリティ上の問題でデータべースサーバーを
インターネットに接続したくない・・・」といった要件があるとする。
その場合はAWS RDS(データベース)を
VPCの『プライベートサブネット』に設置することによって
この要件をクリアできる。

VPC :AWS クラウドのプライベートネットワーク空間
サブネット :ワークロードのネットワーク分離を実現
プライベートサブネット :パブリックインターネットから直接アクセスできない
パブリックサブネット :パブリックインターネットから直接アクセス可能
AWSの責任共有モデルとは
AWSの責任共有モデルとは、
AWSで提供されるシステムにおいて、
AWSが責任を持つ部分と
サービスを利用する顧客が責任を持つ部分を明確に分ける考え方。
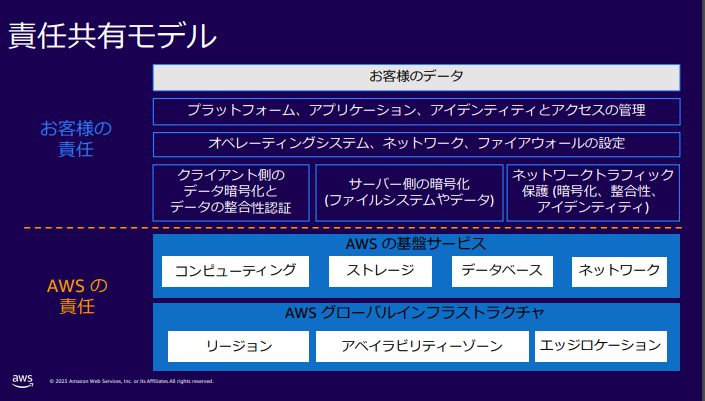
AWSの責任共有モデルで、AWSが責任を負う範囲は、
ハードウェア、ソフトウェア、ネットワーク関連と
AWSクラウドのサービスを実行している施設とされる。
--- AWS側が負う責任範囲の具体例 ---
・データセンターの管理
・インフラストラクチャーの管理
・ホストOS
顧客が責任を負うセキュリティエリアは、
AWSクラウドのサービスによって異なる。
--- ユーザー側の責任範囲の具体例 ---
・ゲストOS
・ネットワーク設定
・アプリケーション
・データの暗号化
・アクセス権限の管理
AWS Identity and Access Management(IAM)とは
AWS Identity and Access Management(AWS IAM)は、
AWSを操作する上で必要となる
アクセス制御権限を管理するユーザ一元管理サービス。
誰がどのサービスに、どのような条件でアクセスできるようにするかを設定できる。
*IAMロールとは
IAMロールとは、AWSサービスやアプリケーションに対して
AWSリソースの操作権限を付与するための仕組み。
ユーザーまたはアプリケーションが、ロールを一時的に引き受けることで
関連付けられたアクセス許可を受けることができる。
*IAMグループ
IAMユーザーの権限をまとめて付与することができる。
IAMポリシー(権限の管理元となるサービス)
AWS のサービスへのアクセスの許可の付与や
IAMポリシーの作成をすることで、
権限を割り当てることができる。
アクセス状況の追跡
*AWS CloudTrailとは
モジュール4: AWS でイノベーション
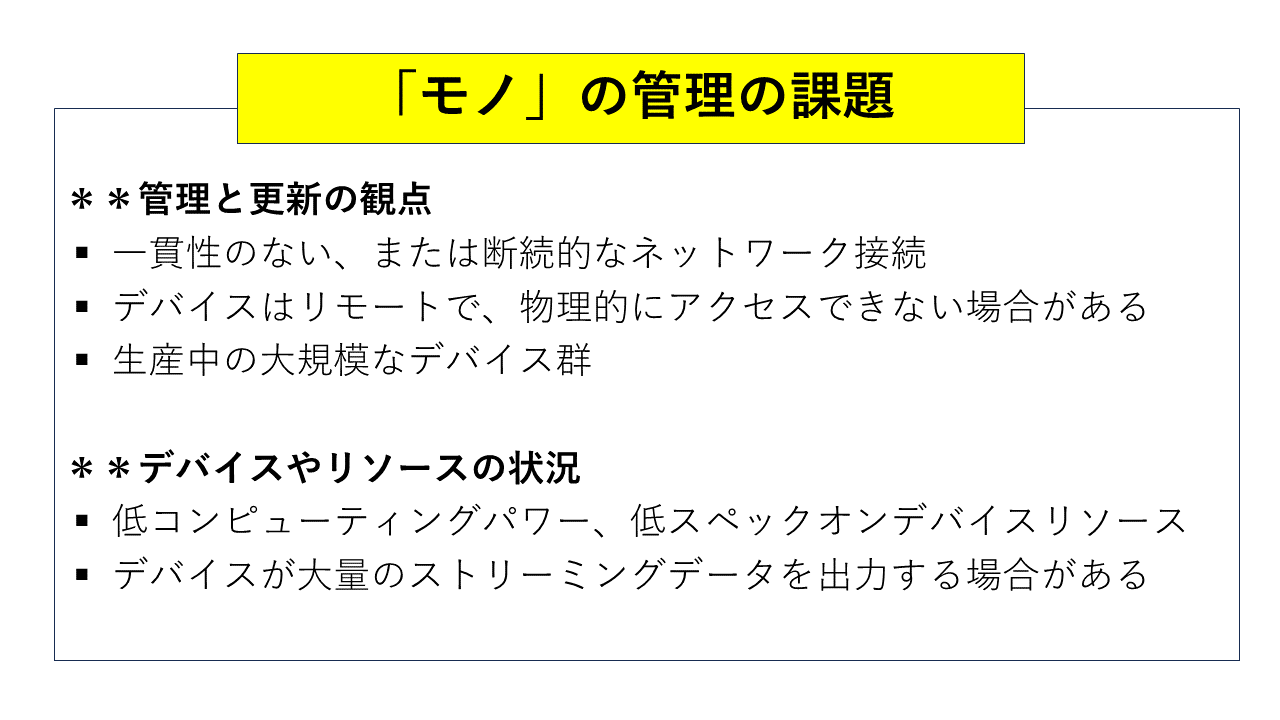
*Internet of Things (IoT)
様々なモノがインターネットに繋がる仕組みのこと。
など、IoT デバイスの管理タスクには多くの課題がある。
AWS IoT Greengrass(グリングラス)
「AWS IoT Greengrass」とは、
AWS上のIoT関連の機能を、
「エッジ(IoTデバイス)」まで拡張するAWSサービス
「エッジコンピューティング」とは?
「エッジコンピューティング」とは、
クラウド以外の場所に、
「コンピューティングリソース」と「データ処理機能」
をもたせること。
センサー等のデータ収集機能だけではなく、
データを処理する機能(コンピューティング)を
「IoTデバイス」に持たせる。
このデバイスが、クラウド側から見た時に「端(エッジ)」に位置するため、
このように呼ばれている。
<具体例>
機械の振動などを検知して異常があると通知をしてくれるシステムがあるとする。
クラウドを介して管理すると、どうしてもタイムラグが発生してしまうが、
Greengrassでは、クラウドを介さないので、
異常を感知したら、即通知を送ることができる。
そのためリアルタイム性、即応性が求められる処理に対応できる。
また、高頻度で発生するデータやプライバシーの配慮が必要な画像などを
クラウドを介さずに現場内で処理ができるようになる。
まとめ
AWSome DayはAWSのサービスについて、
広く把握することができるため
今回の内容はとても学びになりました。
気になる方は参加されてみてください。
最後までご覧いただきありがとうございます。
こんにちは、デジナーレ福岡オフィスの徳安です。
この記事では、React.memoについて説明します。
memoとは
|
|
const MemoizedComponent = memo(SomeComponent) |
構文
memo(Component, arePropsEqual?)
コンポーネントを memo でラップすることで、
そのコンポーネントのメモ化 (memoize) された
バージョンを得ることができる。
このメモ化されたバージョンのコンポーネントは、
親コンポーネントが再レンダーされても、
自身の props が変更されていない限り
通常は再レンダーされなくなる。
引数
Component: メモ化したいコンポーネント。
memo はこのコンポーネントを変更するのではなく、
メモ化が有効になった新たなコンポーネントを返す。
arePropsEqual(省略可能): レンダリング前後の Props の値を
ここで登録した関数が true/false を返すことで、
レンダリングの発生を制御させることが可能。
例えばreturn trueとしてしまうと、
子コンポーネントは永遠にレンダリングされることがなくなる。
再レンダーが発生する条件
再レンダーが発生する条件は、以下の3つ
1. stateが更新されたコンポーネント
2. propsが変更されたコンポーネント
3. 再レンダーされたコンポーネントの配下のコンポ-ネントすべて
(親コンポーネントが再レンダーされたら、子コンポーネントの再レンダーされる)
memoの使用法
memoを使用すると、propsの変更がない限り
親コンポーネントが再レンダーされても
Reactによって再レンダーされないコンポーネントを作成できる。
コンポーネントをメモ化するには、
対象のコンポーネントをmemoでラップし、
返された値を元のコンポーネントの代わりに使用する。
memo を使用することで、props が変更されない限り
再レンダーの必要がないということを
React に伝えることができる。
memoを使用しない場合
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 |
// 親コンポーネント import { useState } from "react"; export const App = () => { console.log("Appレンダリング"); const [num, setNum] = useState(0); const onClick = () => { setNum(num + 1); }; return ( <> <button onClick={onClick}>ボタン</button> <p>{num}</p> <Child /> </> ); }; |
|
|
// 子コンポーネント const style = { backgroundColor: "lightblue", padding: "8px", }; export const Child1 =() => { console.log("Child1レンダリング"); return ( <div style={style}> <p>Child</p> </div> ); }; |
下記のように、不要なレンダリングが発生してしまう。

memoを使用した場合
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 |
// 親コンポーネント import { useState, memo } from "react"; export const App = memo(() => { console.log("Appレンダリング"); const [num, setNum] = useState(0); const onClick = () => { setNum(num + 1); }; return ( <> <button onClick={onClick}>ボタン</button> <p>{num}</p> <Child /> </> ); }); |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 |
// 子コンポーネント import { memo } from "react"; const style = { backgroundColor: "lightblue", padding: "8px", }; export const Child1 = memo(() => { console.log("Child1レンダリング"); return ( <div style={style}> <p>Child</p> </div> ); }); |
メモ化することで、不要なレンダリングを抑えることができる。
memo を使用すべき場所
インタラクションが大まかなものである場合、通常メモ化は不要。
一方、描画エディタのような、
インタラクションが細かなもの(図形を移動させるなど)である場合は、
メモ化することで最適化することができる。
memoによる最適化は、
コンポーネントが全く同一のpropsで頻繁に再レンダーされ、
しかもその際レンダーロジックが高コストである場合に価値がある。
コンポーネントが再レンダーされても遅延を感じられない場合、memoは不要。
レンダー中に定義されたオブジェクトやプレーンな関数を渡しているなど、
コンポーネントに渡されるpropsが毎回異なる場合、
memo は全く無意味となる。
その場合は、useCallbackやuseMemoを一緒に使用する必要がある。
ここまで読み進めていただきありがとうございます。
こんにちは、デジナーレ福岡オフィスの徳安です。
この記事では、useRef()について説明します。
useRefとは
と公式ドキュメントに記載がある。
少し理解しにくいので、簡単に説明すると、
useRefとは、要素の参照を行うためのフックで、
主にDOMへのアクセスに利用される。
useRefはコンポ-ネント内において変数に値を保持することができ、
値を更新してもコンポーネントが
再レンダリングされることはない。
値を保持できるといった面では、useStateと同じだが、
useStateは値が変更されるたびに再レンダリングされる
といった点は異なる。
useRefを利用することで、
無駄な再レンダリングを抑えることが可能になる。
構文
|
|
const ref = useRef(initialValue) |
コンポーネントのトップレベルで
useRefを呼び出して、refを宣言する。
引数
initialValue: ref オブジェクトの
current プロパティの初期値として設定する値。
この引数は2回目以降のレンダーでは無視される。
返り値
渡した initialValue が初期値に設定される。
refオブジェクトをJSXノードのref属性としてReactに渡すと、
Reactはcurrentプロパティの値を返す。
refのDOM操作
初期値をnullに設定したrefオブジェクトを宣言し、
操作したDOMノードのJSXのref属性に、
refオブジェクトを渡す。
|
|
import { useRef } from "react"; const inputRef = useRef(null); const App = () => { const inputRef = useRef(null); return <input ref={inputRef} />; }; |
refオブジェクトのcurrentプロパティに
そのDOMノードが設定される。
作成した、DOMノードにアクセスして、
focus()などのメソッドを呼び出すことが可能になる。
|
|
const Click = () => { inputRef.current.focus(); }; |
Reactは、ノードが画面から削除されると
currentプロパティにnullを戻す。
refとstate
refとstateの違い
初めまして、福岡オフィスエンジニアの佐川です。今回、このブログでは、Amazon Web Services(AWS)の比較的新しいサービス「Amazon Bedrock」について紹介します。最近のクラウド技術の進展を追っている方は、このサービスの存在を耳にしたことがあるかもしれません。Amazon Bedrockの概要から特徴、利用開始までの流れ、使い方、料金を解説していきます。
サービス概要
Amazon Bedrockは、Amazon や主要な AI スタートアップ企業が提供する基盤モデル (FM) を API を通じて利用できるようにする完全マネージド型サービスです。そのため、さまざまな FM から選択して、ユースケースに最も適したモデルを見つけることができます。
https://aws.amazon.com/jp/bedrock/
簡単に言うと、生成系AIアプリを作成・拡張するサービスで、多様なAIと連携し、APIを利用してデータの解析などが行える。と言うことです。
特徴
・完全マネージド型サービス
GPUインスタンスなどを用意する必要はないと言うことです。
・多彩なAIの選択肢
テキスト、コード、画像処理用など、多種多様なAIモデルを利用可能です。
・モデルのカスタマイズ
自社のニーズに合わせてAIを教育し、より賢くすることができます。
・モデルプロバイダーの選択
異なる専門分野を持つ複数のモデルプロバイダーから選択できます。
学習情報の取り扱い
Amazon Bedrockは、学習情報などのデータに関して、プライバシーを守るように作られています。入力した情報や設定したカスタマイズは、ユーザーのAWSアカウント内だけに保たれ、Amazonがサービスを良くするために使ったり、他の会社に渡したりすることはないようです。
したがって、ユーザーデータをトレーニングに使用しないことから、ChatGPTを利用できない企業にとって、新たな選択肢になると思われます。
ChatGPTとの違い
・カスタマイズ性
Amazon Bedrockは、独自のデータでカスタマイズすることができるため、特定のビジネスニーズに合わせてAIを調整することが可能です。そのため開発者は、特定の分野や市場に調整したAIをソフトウェアで利用することができます。
一方で、ChatGPTは、OpenAIによって開発された汎用的なAIモデルで、ユーザーによるAIの調整は限定されています。
・AWSとの関係性
Amazon Bedrockは、AWSと密接に連携しているため、AWSでの作業を簡単にします。AWSで既に使っているツールや機械学習サービスとの連携もスムーズです。
一方で、ChatGPTは、別会社のサービスとなるので、AWSと連携させるためにはAmazon Bedrockよりも、少し手間がかかります。
・データのプライバシーとコントロール
Amazon Bedrockは、ユーザーのAWSアカウント内でのみデータを処理し、プライバシーを守ります。
一方で、ChatGPTは、デフォルトでユーザーの入力データをサービス改善に使用する可能性があり、ユーザーが特別にリクエストしない限り、提供されたデータはプラットフォームの性能向上のために利用されることがあります。
・モデルの提供元
Amazon Bedrockは、複数のAIモデルプロバイダーからのAIモデルを提供しています。多くのAIを提供しているため、開発者は求める条件に特化したAIを選択できます。
一方で、ChatGPTは、OpenAIによって提供される単一のモデルで、利用できるAIが限られています。
上記から、Amazon Bedrockは、自身のニーズに合わせてAIをカスタマイズできることや、データの安全性が確保されているため、特に企業に適していると言えるが、ChatGPTは、迅速で手軽なAI体験を提供しているため、一般ユーザーに適していると言えそうです。
利用開始までの流れ
コンソール画面での準備
まずは、AWSのコンソール画面でAmazon Bedrockの画面を開き、Model Accessというところから、モデルを有効にします。
ちなみに、ブログ作成時点で、ap-northeast-1でのAIモデルは以下のようになっています。us-east-1では全てのAIモデルが使用できます。

今回は、Claude Instantを使用したいため、[Manage model access]を押下後、[Submit use case details]を押下します。

以下の使用理由の詳細情報が表示されるので、必要情報を記入し、[Submit]を押下します。

少しの時間が経過した後、Claude InstantのAccess statusが、<Use case details required>から<Available to request>に変更されるので、再度、[Manage model access]を押下し、Claude Instantにチェックを入れ[Save changes]を押下します。

<In Progress>から<Access granted>に変わるまで待ち、以下のようになればコンソール画面での準備は完了になります。

テスト
バージョン情報
・Python バージョン 3.9.2
・boto3 バージョン 1.28.60
・pandas バージョン 2.1.1
テストコードの検証
今回は以下のコードでテストしました。
料金体系がデフォルトのオンデマンドであれば従量課金制になるので"max_tokens_to_sample": 200の部分の数値を変更することでトークンのMAX値を設定できます。今回は200にしています。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 |
import boto3 import json import pandas as pd # AWSログイン設定 credentials_csv = 'credentials.csv' credentials_key = pd.read_csv(credentials_csv, encoding='cp932') access_key = credentials_key['Access key ID'][0] secret_key = credentials_key['Secret access key'][0] # bedrock の初期設定 bedrock_client = boto3.client( service_name ='bedrock-runtime', region_name ='ap-northeast-1', aws_access_key_id = access_key, aws_secret_access_key = secret_key ) chat_prompt = """ Human: 室内で育てるのに適した植物は何ですか? Assistant: """ body = json.dumps({ "prompt": chat_prompt, "max_tokens_to_sample": 200, }) modelId = 'anthropic.claude-instant-v1' accept = 'application/json' contentType = 'application/json' model_response = bedrock_client.invoke_model( body = body, modelId = modelId, accept = accept, contentType = contentType ) decoded_response = model_response["body"].read().decode() print(json.loads(decoded_response)["completion"]) |
ちなみに、API に送信されるプロンプトは以下のようにする必要があります。
結果は以下のような返答が返ってきました。

料金体系
Amazon Bedrockの料金は、使用するモデルのタイプ、カスタマイズの有無、プロビジョンドスループットの契約期間などによって異なります。
オンデマンド
オンデマンドモードは、実際に使用した量に応じて支払う、従量課金制が採用されています。これは時間に基づいた契約が不要で、不定期に利用する個人ユーザーや使用量が検討がつかない場合に適しています。
テキスト生成では、ユーザーの入力とそれに対する応答の生成に使われるトークンの数に基づいて料金が発生し、画像生成では、生成される画像ごとに料金が発生します。
トークンとは、モデルがユーザーの入力を理解し、適切な応答を生成するために学習する基本単位です。
プロビジョンドスループット
プロビジョンドスループットは、特定のモデルのユニットを購入し、一定のスループットを保証するための料金体系で、大規模で一貫性のある推論ワークロード向けに設計されています。時間単位で課金され、1か月または6か月の契約期間を選ぶことができます。
スループットとは、一定時間内にシステムが処理できるデータ量のことを指します。
モデルのカスタマイズ(微調整)
Amazon Bedrockは、既存のAIモデルに特定のデータセットを用いて追加学習を施すことで、特別なビジネス要件に合わせてモデルをカスタマイズすることもできます。
カスタマイズの費用は、トレーニングに使用するデータの量と学習を繰り返す回数によって決まり、さらに、そのカスタムモデルの保管にも月額料金がかかります。
カスタマイズされたモデルは、オンデマンドではなく、プロビジョンドスループットの処理能力でのみ利用可能です。
初期設定では1モデルユニットから始まり、必要に応じて契約期間を設定してスループットを拡張できます。
モデル別の料金の内訳
AI21 Labs(エーアイ21ラボズ)
<オンデマンド料金>
|
AI21で利用可能なモデル
|
1000トークンの入力(リクエスト)ごとにかかる費用 |
1000トークン出力ごとにかかる費用 |
| Jurassic-2 Mid |
0.01250ドル |
0.01250ドル |
| Jurassic-2 Ultra |
0.001880ドル |
0.01880ドル |
AI21 Lab モデルにおけるモデルのカスタマイズ(微調整)とプロビジョンドスループットの機能は、まだ提供されていません。
Amazon(アマゾン)
<オンデマンド料金>
| AmazonTitanで利用可能なモデル |
1000トークンの入力(リクエスト)ごとにかかる費用 |
1000トークン出力ごとにかかる費用 |
| Titan Text – Lite |
0.0003ドル |
0.0004ドル |
| Titan Text – Express |
0.0013ドル |
0.0017ドル |
| Titan Embeddings |
0.0001ドル |
なし |
<カスタマイズ料金>
| AmazonTitanで利用可能なモデル |
1000トークンのトレーニングにかかる費用※ |
カスタムモデルの
月間保管費用 |
カスタムモデルの推論における1モデルあたり1hの料金(定額契約を結ばない従量課金のスループットコスト) |
| Titan Text – Lite |
0.0004ドル |
1.95ドル |
7.10ドル |
| Titan Text – Express |
0.0008ドル |
1.95ドル |
20.50ドル |
※総トレーニングトークン量 = コーパス内のトークン合計数 × 実行エポックの総数
<プロビジョンドスループット料金>
| AmazonTitanで利用可能なモデル |
1時間のモデル使用料
(契約なし)※ |
1時間のモデル使用料
(1か月)※ |
1時間のモデル使用料
(6か月)※※ |
| Titan Text– Lite |
7.10ドル |
6.40ドル |
5.10ドル |
| Titan Text – Express |
20.50ドル |
18.40ドル |
14.80ドル |
| Titan Embeddings |
なし |
6.40ドル |
5.10ドル |
※契約を結ばずに利用するカスタムモデルの推論は、モデルユニットを1つまでに限定されています。※※ベースおよびカスタムモデルの推論に適用され、複数モデルユニットの購入が可能になります。
おおよその金額例
想定:Titan Text– Liteのモデルユニット1つを1ヶ月間の契約で購入し、利用した場合
毎月の総料金=1ユニット×$6.40/時×24時間×31日=$4,761.6×約150円/$=約71万4240円
Anthropic(アンスロピック)
<オンデマンド料金>
|
Anthropicで利用可能なモデル
|
1000トークンの入力(リクエスト)ごとにかかる費用 |
1000トークン出力ごとにかかる費用 |
| Claude Instant |
0.00163ドル |
0.00551ドル |
| Claude |
0.01102ドル |
0.03268ドル |
<プロビジョンドスループット料金>
|
Anthropicで利用可能なモデル
|
1時間のモデル使用料(1か月)※ |
1時間のモデル使用料(6か月)※ |
| Claude Instant |
39.60ドル |
22.00ドル |
| Claude |
63.00ドル |
35.00ドル |
※ベースモデル及びカスタムモデルの推論をカバーしています。
おおよその金額例
想定:Claude Instantのモデルユニット1つを1ヶ月間の契約で購入し、利用した場合
毎月の総料金=1ユニット×$39.60/時×24時間×31日=$29,462.4×約150円/$=約441万9360円
Cohere(コーヒア)
<オンデマンド料金>
|
Cohereで利用可能なモデル
|
1000トークンの入力(リクエスト)ごとにかかる費用 |
1000トークン出力ごとにかかる費用 |
| Command |
0.0015ドル |
0.0020ドル |
Cohereモデルにおけるモデルのカスタマイズ(微調整)とプロビジョンドスループットの機能は、まだ提供されていません。
Stability AI(スタビリティエーアイ)
<オンデマンド料金>
|
StabilityAIで利用可能なモデル
|
画像解像度 |
標準的な品質
(50ステップ以下の範囲) |
上質レベルの品質
(50ステップを超える範囲) |
| SDXL0.8 |
512x512 まで |
画像あたり0.018ドル |
画像あたり0.036ドル |
| 512x512 を超える範囲 |
画像あたり0.036ドル |
画像あたり0.072ドル |
<プロビジョンドスループット料金>
|
StabilityAIで利用可能なモデル
|
1時間のモデル使用料(1か月)※ |
1時間のモデル使用料(6か月)※ |
| SDXL1.0 |
49.86ドル |
46.18ドル |
※ベースモデル及びカスタムモデルの推論をカバーしています。
Stability AIモデルにおけるモデルのカスタマイズ(微調整)の機能は、まだ提供されていません。
おおよその金額例
想定:SDXL1.0のモデルユニット1つを1ヶ月間の契約で購入し、利用した場合
毎月の総料金=1ユニット×$49.86/時×24時間×31日=$37,095.84×約150円/$=約556万4376円
終わりに
このブログではAmazon Bedrockについて解説しました。Claudeのようなモデルを使った日本語対話の可能性から、AWSのシームレスな統合まで、Amazon BedrockはAIの利用を手軽にし、開発者や企業に新たな可能性をもたらしてくれます。
今回取り上げたClaudeは日本語の長い文章にも対応しており、チャットボットとしての機能も期待できるみたいです。
是非、この機会にAmazon Bedrockの機能を試し、自分のビジネスやプロジェクトにどう活かせるか探ってみてください。このブログがその第一歩となり、読者の皆様にとって有用な情報源となれば幸いです。
こんにちは、デジナーレ福岡オフィスの徳安です。
この記事では、useContextについて説明します。
useContextとは
useContextはコンポーネントで、
コンテクスト(context)の読みとりと
サブスクライブ(subscribe, 変更の受け取り)を
行うためのReactフック。
|
|
const value = useContext(SomeContext) |
通常、親コンポーネントから
子コンポーネントには
propsを使って情報を渡す。
propsを受け渡す際、
多数の中間コンポーネントを
経由して渡さないといけない場合や、
アプリ内の多くのコンポーネントが
同じ情報を必要とする場合、
propsの受け渡しは冗長で、不便なものになる。
→props drilling(propsのバケツリレー)
と呼ばれる状況に陥る。
そういった際に、
コンテクストを使用することで、
親コンポーネントから、
propsを明示的に受け渡さなくても
任意のコンポーネントが
情報を受け取れるようにできる機能。
=== サンプル ===
コンポーネントのトップレベルで
useContextを呼び出して、
サブスクライブする。
<ファイル構成>
・propsの受け渡しで、stateを渡す場合
【APP.jsx】
|
|
import { useState } from "react"; import SampleA from "./components/SampleA"; const App = () => { const [user, setUser] = useState({ name: "taro", age: 20, }); return ( <div className="App"> <SampleA user={user} /> </div> ); }; export default App; |
【SampleA】
|
|
import React from "react"; import SampleB from "./SampleB"; const SampleA = ({ user }) => <SampleB user={user} />; export default SampleA; |
【SampleB】
|
|
import React from "react"; import SampleC from "./SampleC"; const SampleB = ({ user }) => <SampleC user={user} />; export default SampleB; |
【SampleC】
|
|
const ContextC = ({ user }) => { return ( <p> {user.name}: {user.age}歳です。 </p> ); }; export default ContextC; |
このように親コンポーネントから値を受け渡す際に
バケツリレーで値を受け渡しているため
不要なpropsの受け渡しが発生している。

・contextを使用して、値を受け取れるようにする場合
【APP.jsx】
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 |
import { createContext, useState } from "react"; import SampleA from "./components/SampleA"; // UserContextを利用できるようにするためにexportし、 // ContextオブジェクトであるUserContextを作成 export const UserContext = createContext(); const App = () => { const [user, setUser] = useState({ name: "taro", age: 20, }); return ( <div className="App"> {/* providerを作成、valueにuserをセットする */} <UserContext.Provider value={user}> <SampleA /> </UserContext.Provider> </div> ); }; export default App; |
【SampleA.jsx】
|
|
import React from "react"; import SampleB from "./SampleB"; // 不要なpropsの受け渡しがなくなる。 const SampleA = () => <SampleB />; export default SampleA; |
【SampleB.jsx】
|
|
import React from "react"; import SampleC from "./SampleC"; // 不要なpropsの受け渡しがなくなる。 const SampleB = () => <SampleC />; export default SampleB; |
【SampleC.jsx】
|
|
import { useContext } from "react"; import { UserContext } from "../App"; const ContextC = () => { //useContextの引数に、UserContextを渡すことによって、 //AppコンポーネントでProviderに渡したvalueの値を変数に代入することが出来る const user = useContext(UserContext); return ( <p> {user.name}: {user.age}歳です。 </p> ); }; export default ContextC; |
useContextを使用すれば、
ツリー内の様々な階層から、
Contextに収容されている
データへアクセスすることができる。
ここまで読み進めていただきありがとうございます。